Ogni prodotto che tocca immobili o territorio prima o poi si ferma davanti alla stessa domanda: come faccio entrare i dati catastali nel mio software? La risposta giusta dipende da tre variabili che quasi nessuno misura in anticipo: la freschezza che serve davvero, il volume di richieste, e chi si occuperà della manutenzione. Questo articolo mette le tre strade una accanto all'altra, con i numeri della nostra esperienza in produzione.
Le tre strade
Le strade sono tre. La prima è un'API interrogata a richiesta: il software chiama, riceve i dati, li usa. La seconda è una pipeline ETL: i dati si scaricano in blocco, si puliscono e si caricano in un database proprio. La terza sono i file statici: dataset scaricati a mano o in automatico, usati così come sono.
Nessuna delle tre è migliore in assoluto. Cambia il punto di equilibrio, e il punto di equilibrio si sposta con la scala.
| API a richiesta | Pipeline ETL | File statici | |
|---|---|---|---|
| Freschezza | In tempo reale | Quanto buona è la pipeline | Quella dell'ultimo download |
| Costo di avvio | Basso, si parte subito | Medio, serve un progetto dati | Quasi zero |
| Costo di mantenimento | Prevedibile | Alto, la pipeline va curata | Basso ma manuale |
| Volumi | Fino a migliaia di richieste l'ora | Milioni di righe senza problemi | Nessun vincolo di richieste |
| Quando sceglierla | Lookup su singole particelle, dati sempre aggiornati | Analisi massive, join con dati interni | Demo, MVP, analisi saltuarie |
L'API a richiesta, quando il dato serve ora
Se il software deve rispondere a domande puntuali, come "dimmi tutto su questa particella" o "quali sono le quotazioni OMI in questa zona", l'API vince. Il dato arriva fresco, non occupa spazio nel vostro database, e chi mantiene l'API si occupa degli aggiornamenti. La nostra pagina API mostra bene cosa intendiamo per "tutto su questa particella": una singola chiamata restituisce oltre 80 campi organizzati in 17 sezioni, dai dati catastali ai rischi, dalle quotazioni ai dati demografici.
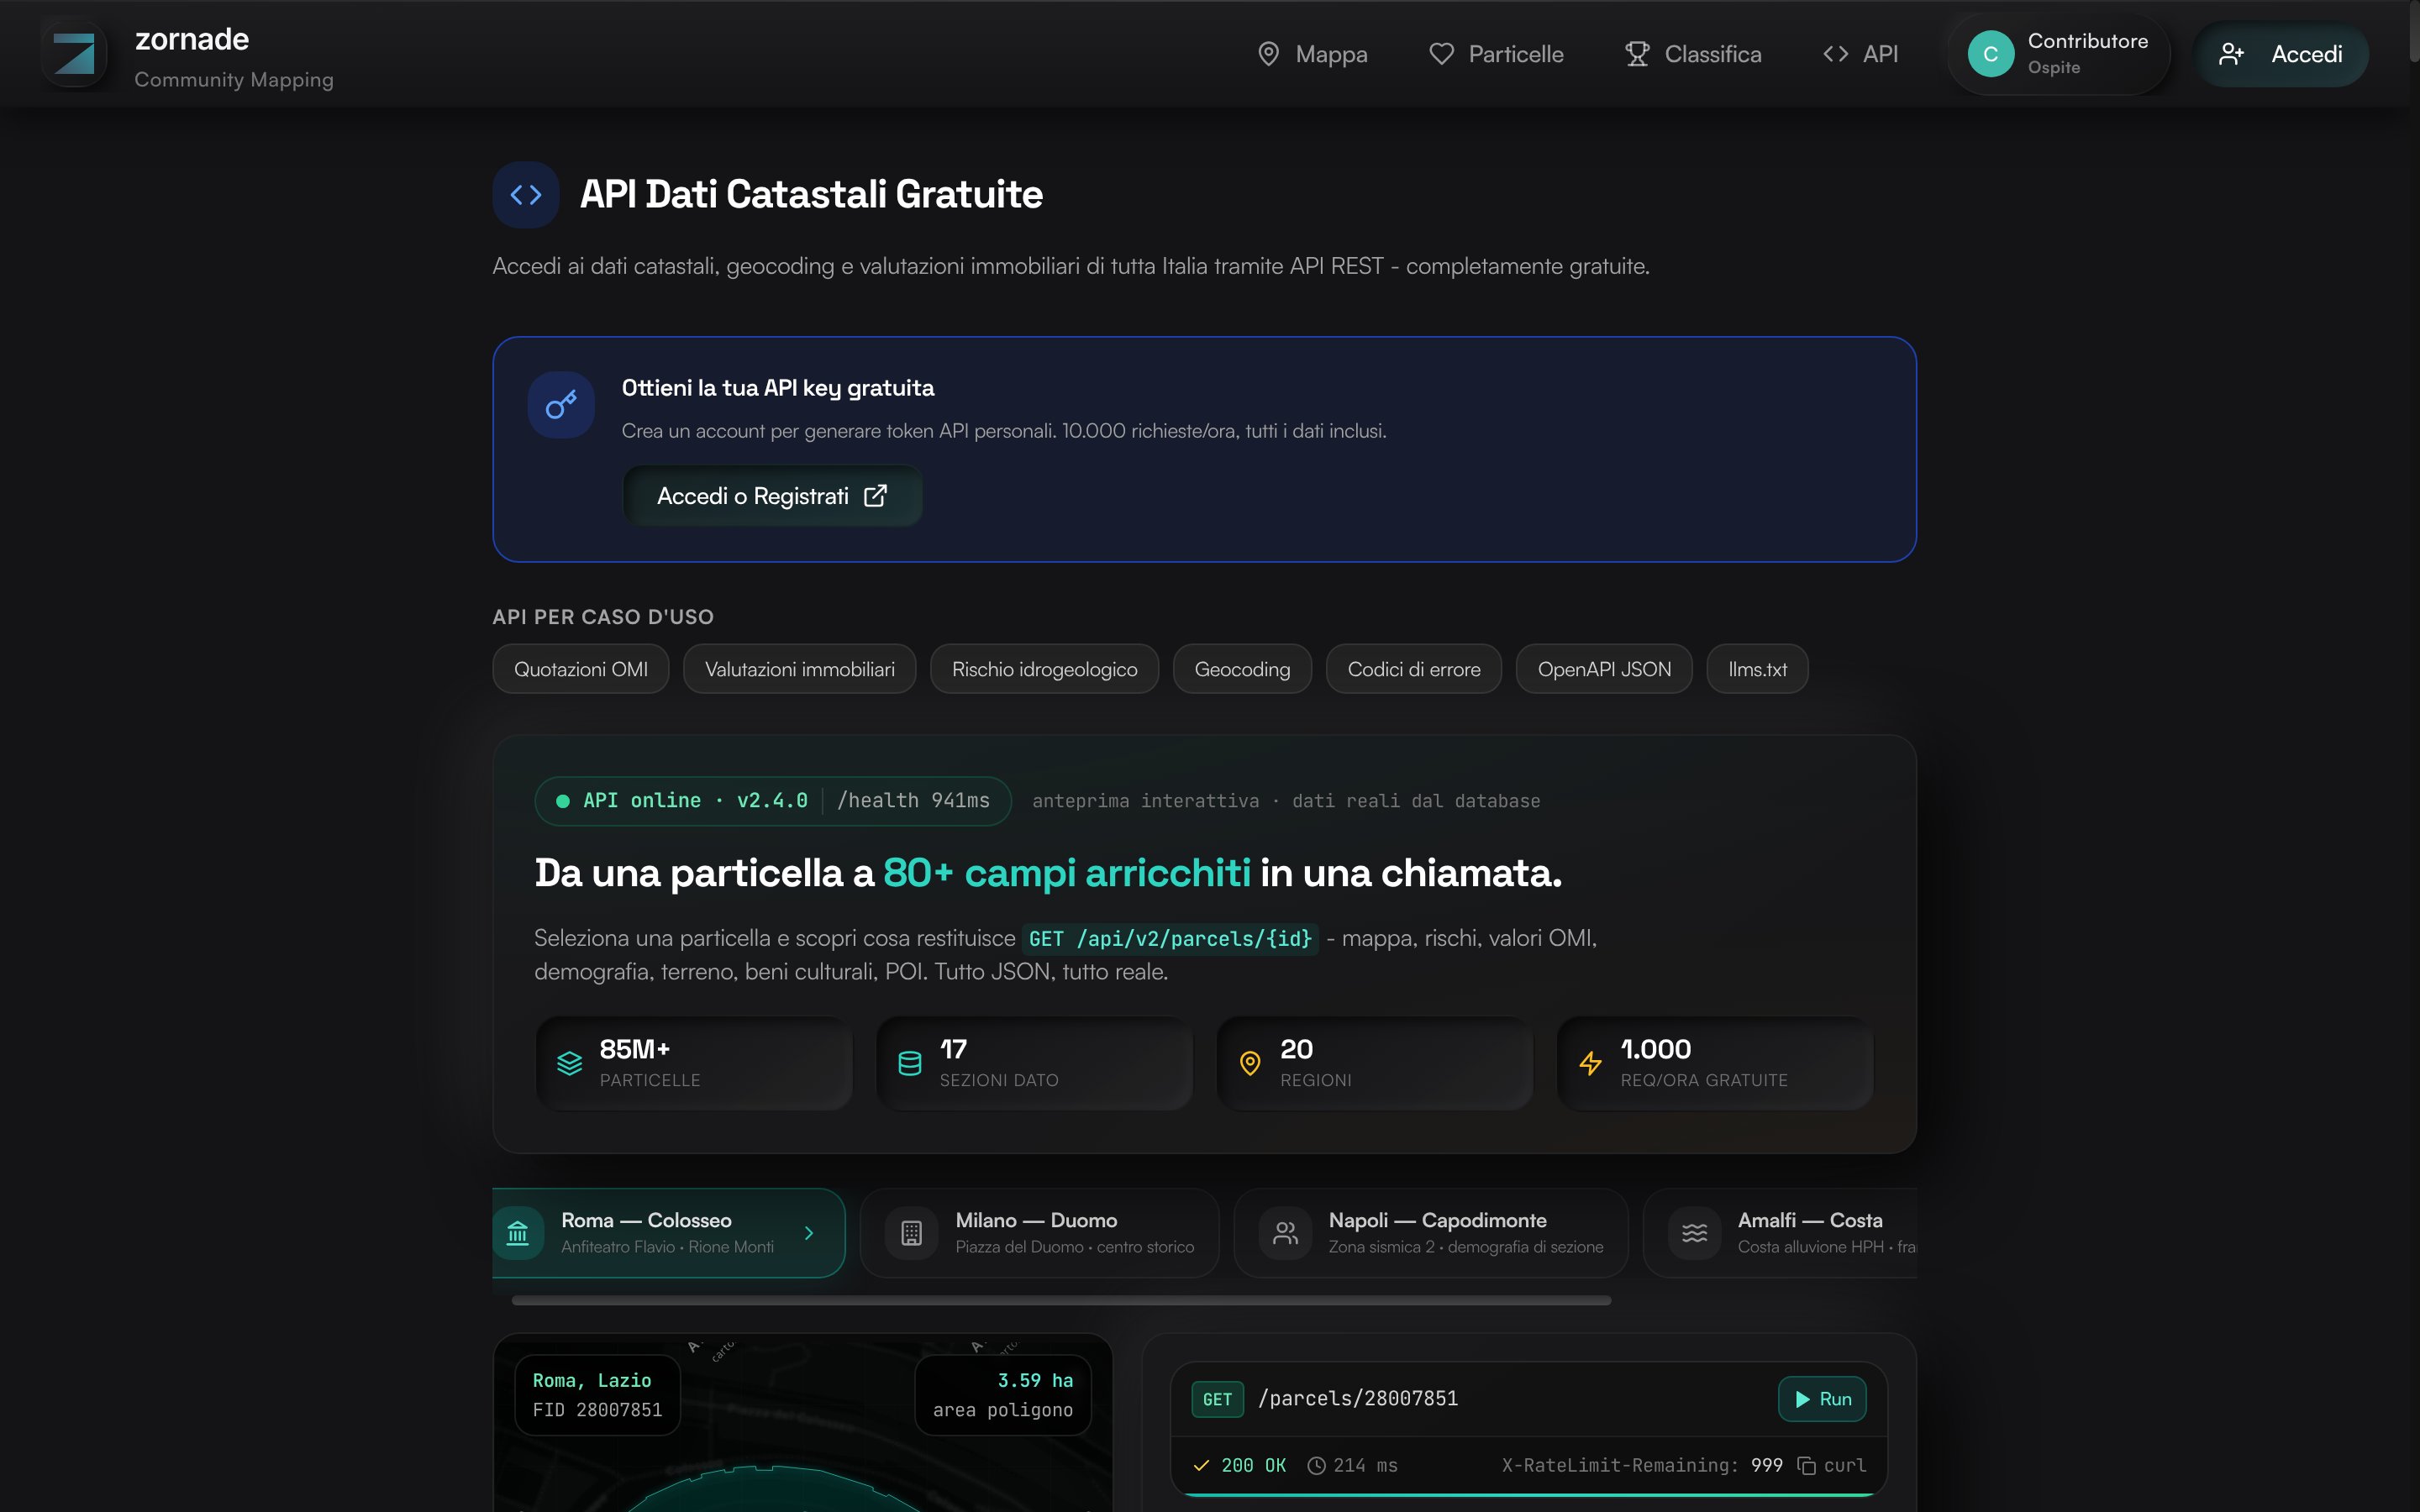
Il playground della pagina API di Zornade. Una chiamata a GET /api/v2/parcels/{id} restituisce mappa, rischi, valori OMI, demografia e molto altro in un unico JSON.
Il vincolo dell'API è il volume. Il piano gratuito della nostra API ammette 10.000 richieste all'ora con attribuzione visibile, e per la maggior parte dei prodotti in avvio quel tetto basta e avanza. Chi supera volumi simili in modo continuativo sta già facendo un altro mestiere, e lì serve una pipeline.
L'ETL, quando i dati diventano vostri
La pipeline ETL conviene quando i dati servono in blocco: analisi su intere province, join con anagrafiche interne, cruscotti che aggregano migliaia di particelle. Si scarica una fonte, la si trasforma, la si carica in PostGIS o nel data warehouse aziendale, e da lì si interroga senza limiti.
Il prezzo si paga dopo. Le fonti pubbliche italiane, dal WFS del geoportale catastale distribuito con licenza CC-BY 4.0 ai file OMI dell'Agenzia, cambiano formato e struttura con una regolarità che chi non ha mai mantenuto una pipeline sottovaluta. Nella nostra esperienza la prima ingestione di una fonte nazionale richiede giorni, mantenerla viva richiede un controllo ogni mese. Una pipeline si alleva più che costruirsi.
I file statici, quando basta poco
Per una demo, un MVP o un'analisi una tantum i dataset scaricabili restano la strada più breve. Il nostro portale di download offre le particelle, le sezioni urbane e altri dataset già puliti, in GeoPackage e GeoJSON, con licenze chiare. Si scarica, si importa in QGIS o nel database, si lavora.
Il limite dei file è lo scollamento: dopo sei mesi il dataset è vecchio, e i confronti con il catasto aggiornato cominciano a scricchiolare. Per i prodotti in produzione questo scollamento è un bug latente, del tipo che emerge con un cliente arrabbiato che mostra la visura fresca accanto al vostro dato vecchio.
Il criterio di scelta, in pratica
La domanda che ci facciamo noi prima di consigliare una strada è una sola: quanti dati deve muovere il prodotto in una settimana? Sotto le mille particelle, l'API è quasi sempre la scelta giusta. Sopra le centomila, l'ETL smette di essere un'opzione e diventa l'architettura. In mezzo, si sceglie guardando al team: se in azienda c'è qualcuno che sa tenere in piedi una pipeline, l'ETL paga; se il prodotto deve uscire presto, l'API permette di partire subito e di ripensare l'architettura quando i volumi lo chiederanno.
C'è un terzo elemento che entra nella scelta e pesa più di quanto sembri: l'attribuzione. L'API gratuita richiede la scritta Zornade visibile nel prodotto, e per chi la vuole togliere esiste la licenza commerciale. Un ETL costruito su fonti pubbliche non ha questo vincolo, ma si porta dietro l'obbligo delle attribuzioni alle fonti, che valgono sempre. Quando confrontate le due strade, confrontate anche questo costo.
Quanto costa davvero
Abbiamo già messo i numeri su carta in un articolo dedicato: quanto costa integrare i dati catastali in un gestionale, con le voci che le stime dimenticano di solito, aggiornamenti, monitoraggio, gestione degli errori. Vale la lettura prima di aprire un progetto di integrazione, qualunque strada scegliate.
Domande frequenti
API o ETL, cosa conviene per un gestionale immobiliare?
Dipende dai volumi e dall'uso. Per arricchire schede di singoli immobili al momento della consultazione, l'API è la strada più rapida e si parte con un account gratuito. Se il gestionale deve fare analisi di portafoglio su migliaia di immobili ogni notte, una pipeline ETL con dati caricati in un database proprio rende di più.
I dati scaricati con l'ETL restano aggiornati da soli?
No. La pipeline va eseguita con regolarità e va monitorata, perché le fonti pubbliche cambiano formati e strutture. Chi sottovaluta questo punto scopre dopo mesi che il proprio database ha smesso di aggiornarsi in silenzio.
Posso usare i file WFS dell'Agenzia delle Entrate in un prodotto commerciale?
Sì, il WFS del geoportale catastale è distribuito con licenza CC-BY 4.0 e se ne consente l'uso rispettando l'attribuzione. Il lavoro di ingestione, pulizia e aggiornamento resta a carico vostro.
Quanto tempo serve per partire con l'API?
Minuti. Si crea un account sull'app, si genera la chiave, e si prova la prima chiamata nel playground. La documentazione con gli esempi pronti accompagna ogni endpoint.
Il piano gratuito dell'API basta per un prodotto reale?
Il piano gratuito ammette 10.000 richieste all'ora con attribuzione visibile. Per la maggior parte dei prodotti in avvio è più che sufficiente, e quando i volumi crescono si passa alla licenza commerciale, che toglie l'attribuzione Zornade.
Serve un team di sviluppatori per l'ETL?
La prima ingestione sì, e il monitoraggio continuo anche. Una pipeline ETL su fonti pubbliche italiane richiede competenze geospaziali, PostGIS o simili, e un calendario di controlli. Chi non ha queste risorse interne parte meglio con l'API e sposta i dati solo quando i volumi lo giustificano.
Le tre strade si possono mescolare?
Sì, ed è quello che consigliamo di solito: API per i lookup in tempo reale, ETL per l'analitica, file per le esigenze occasionali. Le tre strade convivono quasi sempre, e la scelta vera è quale di loro porta il carico principale.
La scelta dell'architettura dati si rifà ogni volta che il prodotto cambia scala. Se state partendo adesso, il percorso più corto passa dal playground dell'API, e per chi costruisce un prodotto commerciale senza la scritta Zornade c'è la licenza commerciale. Se invece il dubbio è architetturale e volete un parere prima di impegnarvi, raccontateci il caso.
Foto di copertina: Stanislav Kondratiev su Pexels